FlashVSR 视频超分放大实战经验:17FPS 实时超分 + ComfyUI 提速全攻略
🚀 FlashVSR 视频超分放大实战经验:17FPS 实时超分 + ComfyUI 提速全攻略 从原理到落地:为什么 FlashVSR 能把扩散模型视频超分做到实时,以及 TE Speed 等 ComfyUI 实现怎么选、怎么调、怎么避坑 📅
🚀 FlashVSR 视频超分放大实战经验:17FPS 实时超分 + ComfyUI 提速全攻略
从原理到落地:为什么 FlashVSR 能把扩散模型视频超分做到实时,以及 TE-Speed 等 ComfyUI 实现怎么选、怎么调、怎么避坑
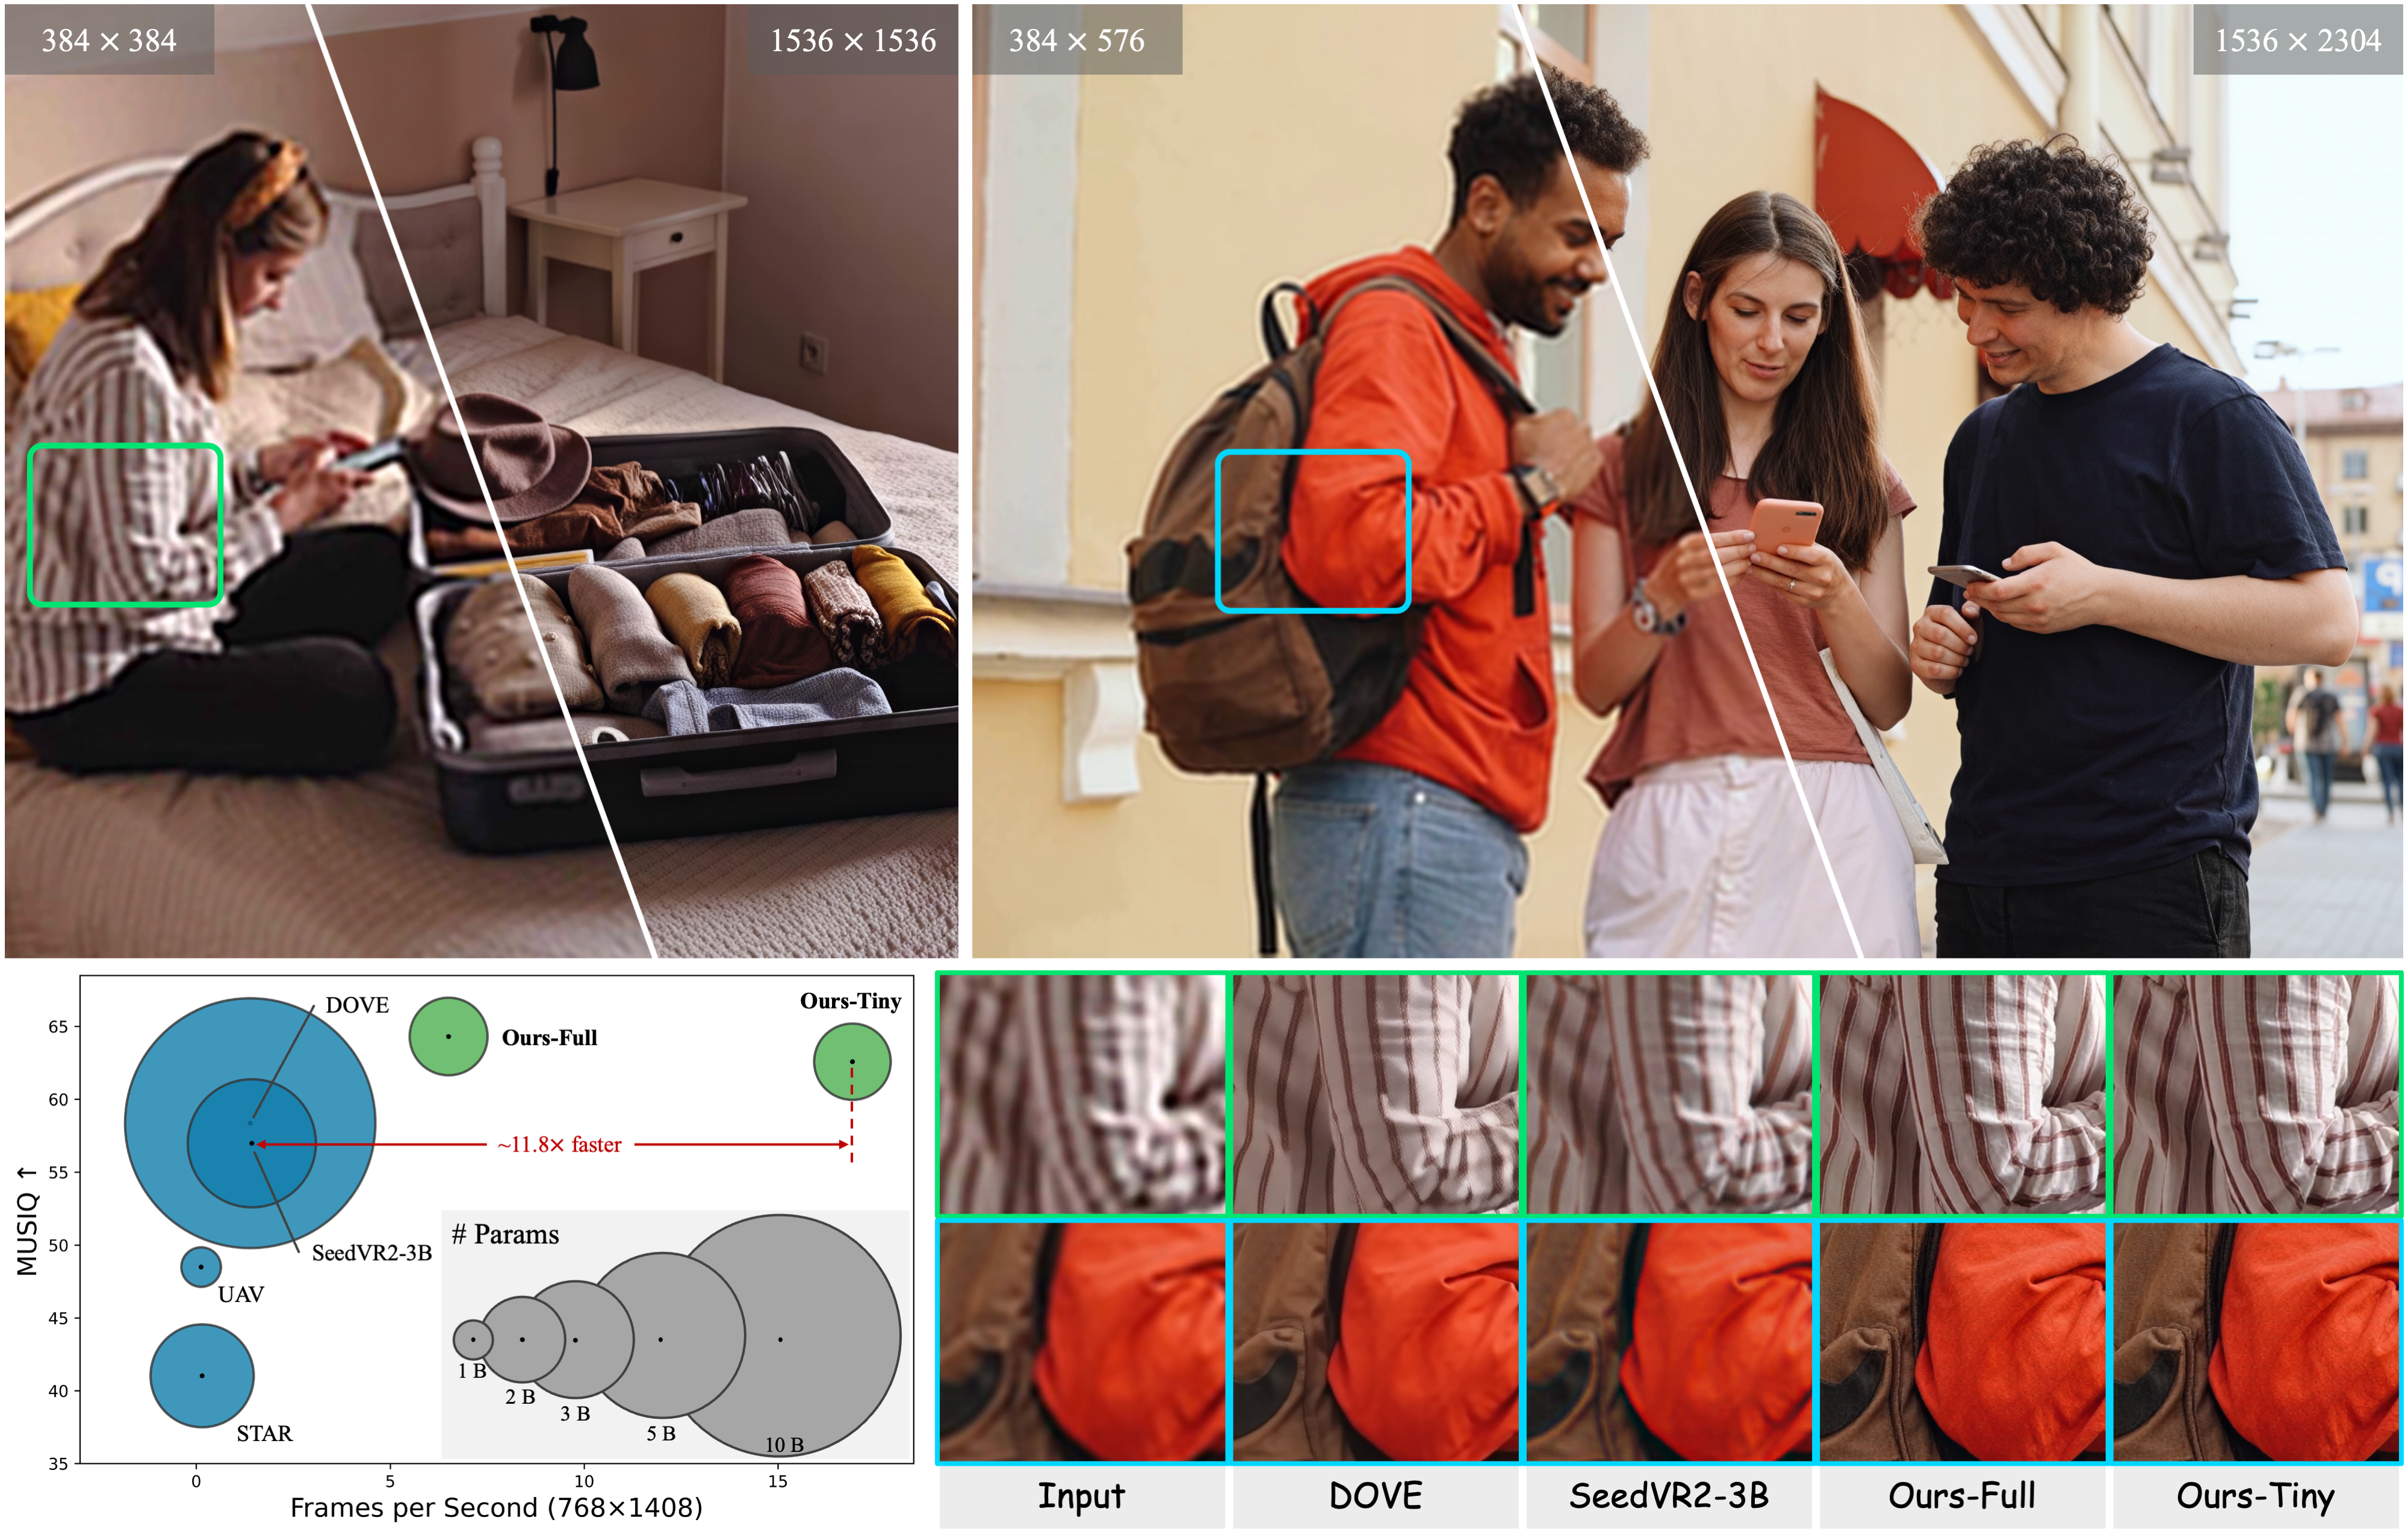
AI 视频生成普及后,"把低清视频放大变高清"成了高频需求。传统插值算法快但细节是猜的;扩散模型超分细节好,却慢得离谱——一段 10 秒视频跑几十分钟是常态。FlashVSR(清华 / 上海AI实验室 / 港中文,CVPR 2026)把扩散模型视频超分做到了实时:768×1408 分辨率下单张 A100 跑出约 17 FPS,比之前的单步扩散超分快约 12 倍。本文讲清楚三件事:它凭什么快、普通用户怎么用起来(重点:ComfyUI 四条路线怎么选)、以及 TE-Speed 这条最快路线的调参经验。
- 实时流式超分:单步扩散 + 流式推理,一边读帧一边出片,约 17 FPS @ 768×1408(A100)
- 最高约 12× 加速:对先前单步扩散 VSR 模型,画质保持 SOTA,还能扩展到超高清
- 消费级显卡可玩:ComfyUI 社区节点 8GB 显存也能跑(有低显存配置)
- TE-Speed 路线:运动感知动态加速 + 合帧编码提速 50%,全链路最快
⚡ 3分钟看懂版
是什么
基于扩散模型的实时流式视频超分:输入低清/模糊视频,输出放大 4 倍的高清视频,流式处理不用等整段视频跑完。
能干什么
老视频/低清素材修复放大;AI 生成视频(普遍 480p/720p)放大到高清再发平台;直播/预览场景实时增强。
适合谁
有 NVIDIA 显卡、用 ComfyUI 的用户;做视频二创/修复/优化刻的创作者。没显卡可以直接用云端 API。
不适合谁
想放大图片的(这是视频模型);没有 NVIDIA 显卡又不想用云的;期待一键全自动零调参的(有社区整合包会省很多事)。
🔬 为什么能到 17FPS(原理速览)
扩散模型做视频修复画质好,但直接用有三个死穴:延迟高、计算量爆炸、超高分辨率下泛化差(纹理重复/花屏)。FlashVSR 用三个互补技术逐一击破:
1️⃣ 三阶段蒸馏 —— 把"多步"变"一步"
把多步扩散教师模型蒸馏成"单步"学生模型:原本要去噪几十步,现在一步出结果。这是"实时"的前提,也是流式推理的基础。
2️⃣ LCSA 局部约束稀疏注意力 —— 治花屏 + 提速
推理分辨率超过训练范围时,位置编码(RoPE)的角度会周期性"绕回",产生纹理重复和混叠。LCSA 让每个位置只看局部窗口:既把推理时的位置范围对齐训练(治花屏),又把注意力计算量砍掉一大截(提速)。
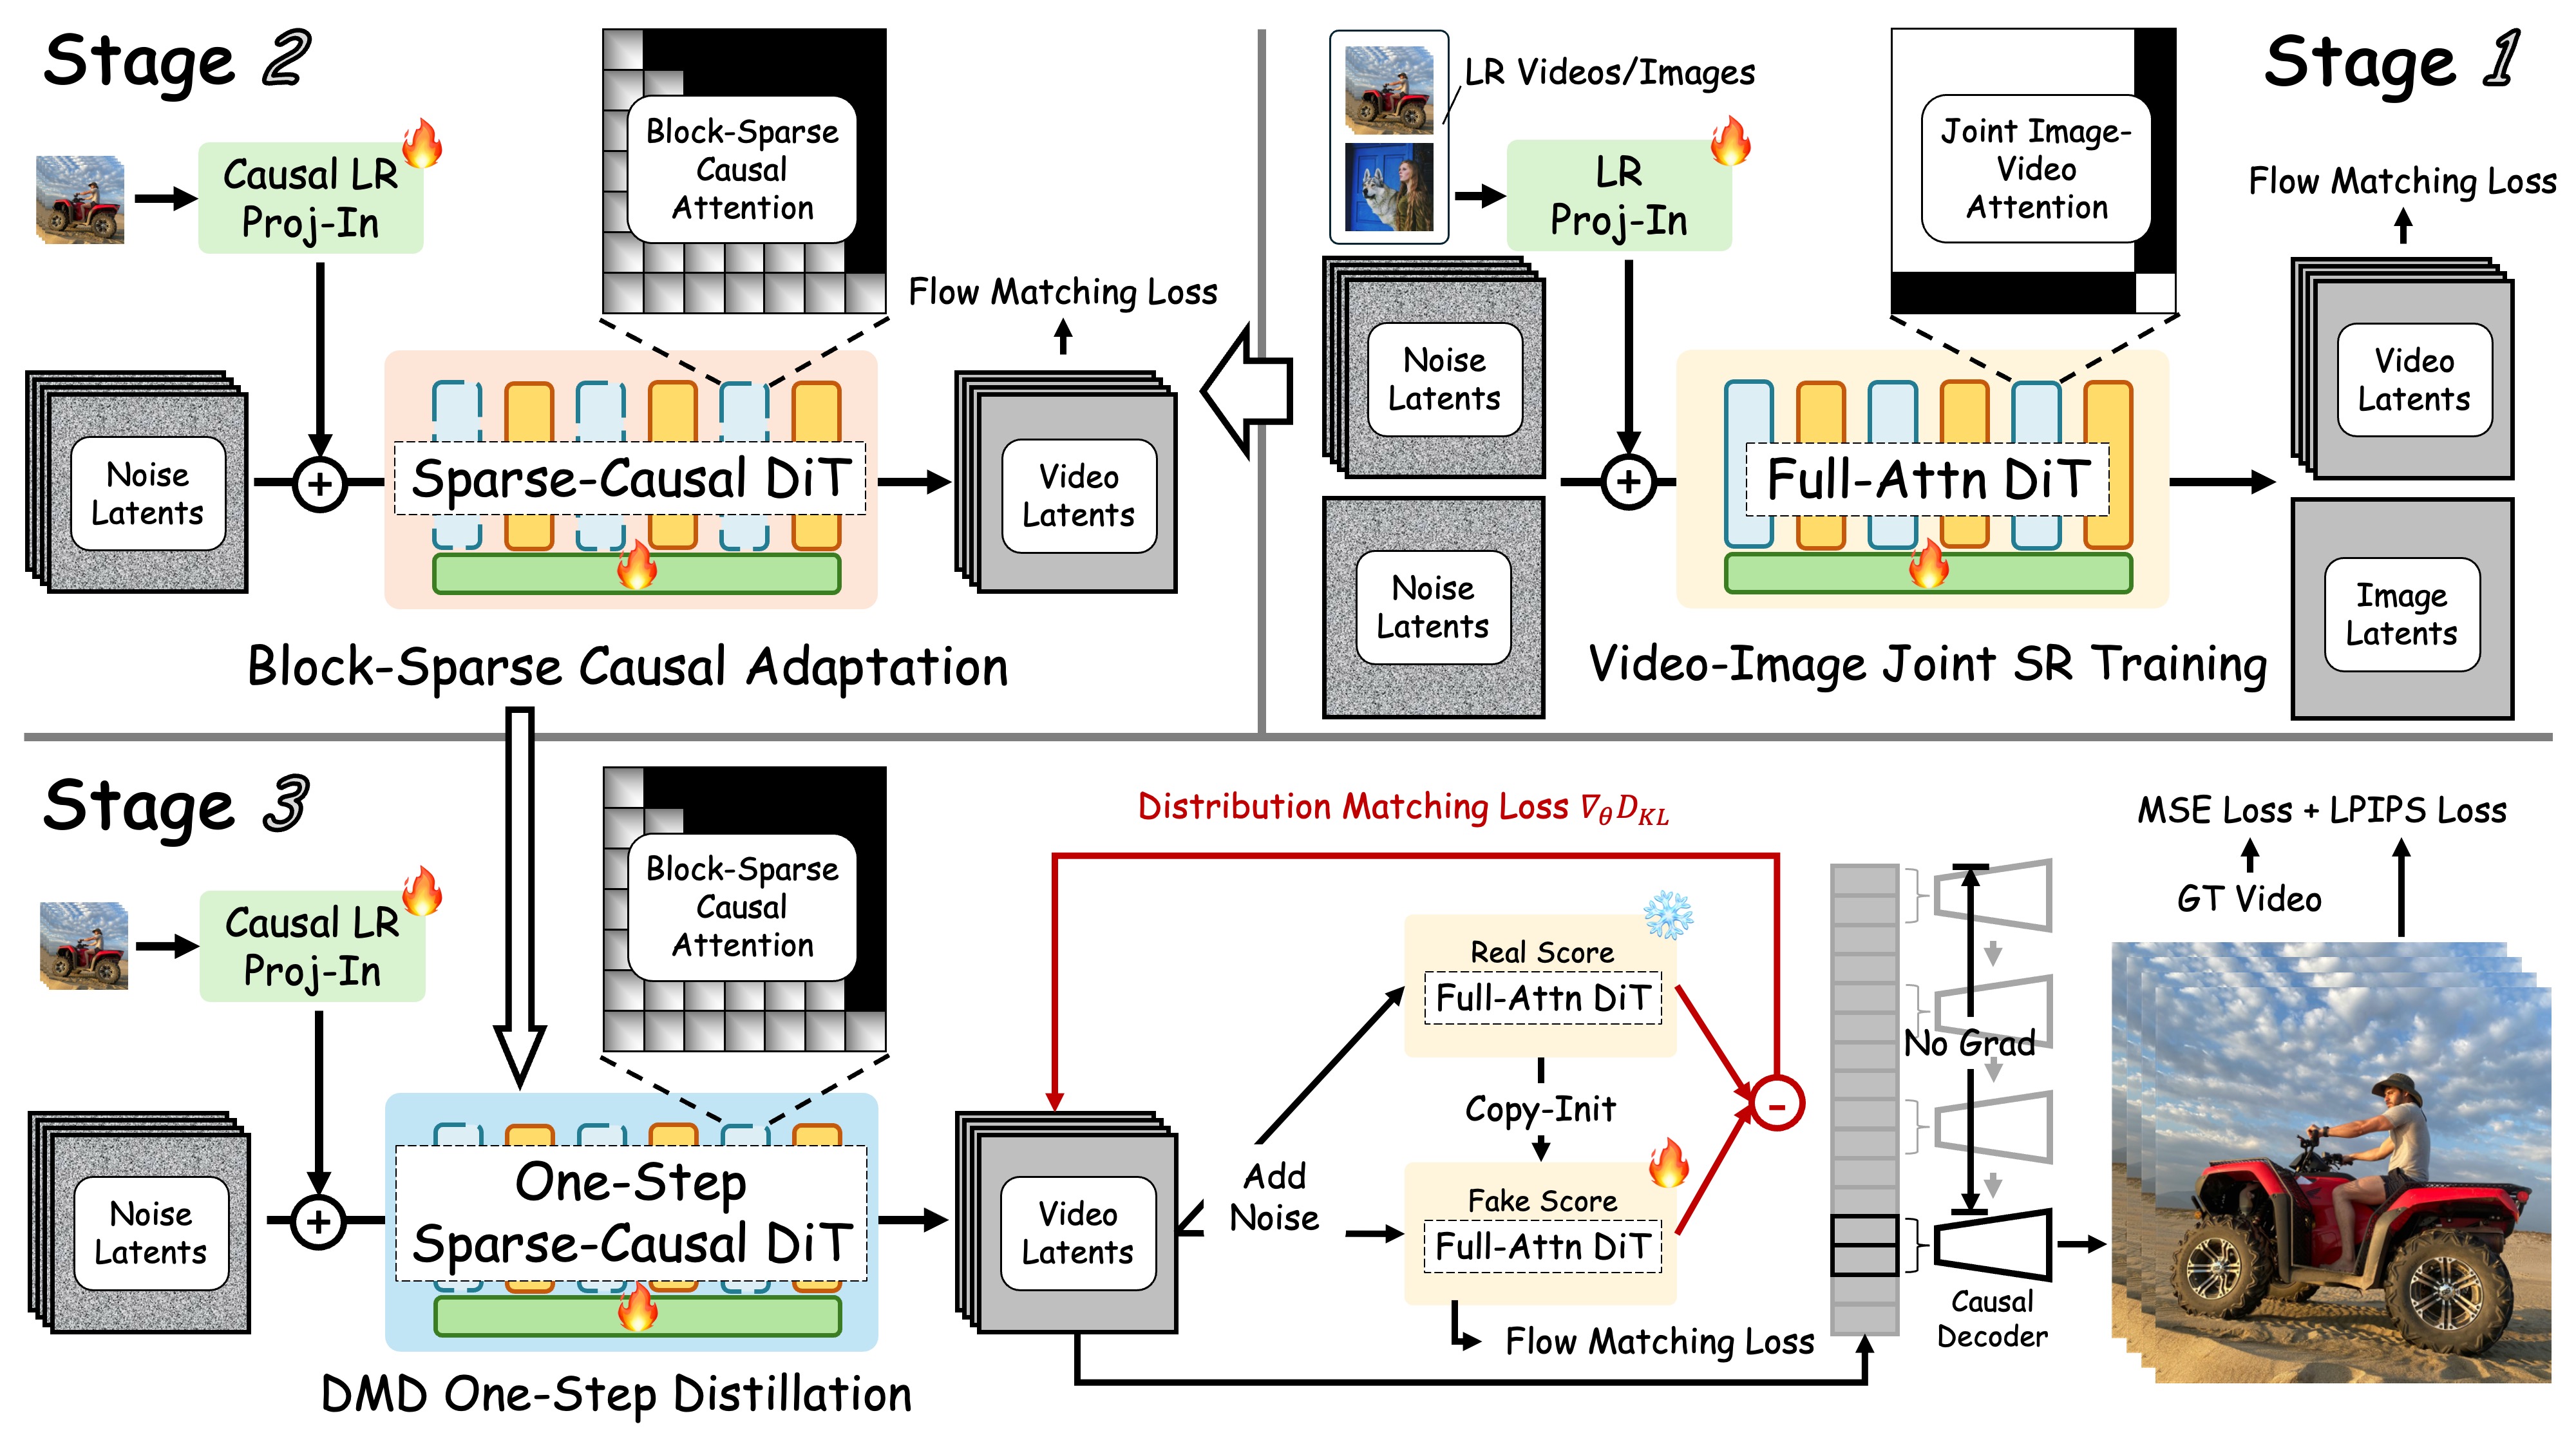
3️⃣ TC 小解码器 —— 解码提速 7 倍
解码时把低清帧也喂给解码器当"参照",高分辨率重建变简单:解码速度提升 7 倍,画质与原版 VAE 几乎无差别。配套的 VSR-120K 数据集(12 万视频 + 18 万图像)保证了训练质量。
🛠️ 怎么用起来:版本 + 四条路线 + 云端
| ComfyUI 路线 | 特点 | 适合谁 |
|---|---|---|
| lihaoyun6 / Ultra_Fast | 用 Sparse_Sage 替代需编译内核的 Block-Sparse-Attention,装完即用;支持 RTX 50 系;tile_dit 降显存;有长视频管线 | 新手首选,安装最省事 |
| tl2012tl / TE-Speed | 全链路最快:运动感知动态加速 + SpargeAttn 稀疏注意力 + 独家合帧编码提速 50% | 追求速度的进阶用户(下文重点) |
| naxci1 / Stable | 5 种 VAE 可选(Wan2.1/2.2、LightVAE、TAE)、显存预估、模型自动下载、低显存配置最全 | 显存 8-16GB 的用户 |
| smthemex | 最接近官方实现(保留 LCSA) | 追求官方还原度 |
📋 通用安装步骤(以 Ultra_Fast 为例,点开照做)
① clone 到 ComfyUI/custom_nodes,pip install -r requirements.txt(Turing 或更老显卡需额外装 triton<3.3.0)。
② 模型整个文件夹(4 个文件)放到 ComfyUI/models/FlashVSR/(TE-Speed 为 models/FlashVSR-v1.1/)。
③ 工作流:帧序列(VHS Load Video)→ FlashVSR 节点(mode=tiny 快 / full 质量高;scale=4;color_fix 开)→ Video Combine 输出 MP4。单张图直接塞 Frames 输入也能放大。
④ 不想折腾本机:fal.ai / WaveSpeed / Segmind 等云 API 开箱即用(注意第三方云可能跑 v1 或未实现完整管线,结果与官方有差异)。
🏎️ TE-Speed-FlashVSR 详解与调优经验(重点)
TE-Speed 是社区里把 FlashVSR 推到最快的路线,在"接入"之外做了四层加速,每一层都独立可控:
1️⃣ 运动感知动态加速(核心卖点)
分析相邻帧运动变化 → 按时间块计算运动强度 → 动态调整注意力 Top-K、KV 保留量和局部范围 → 用 SpargeAttn CUDA 稀疏内核执行。画面静止的地方少算,动的地方多算,预算花在刀刃上。
2️⃣ 三档质量档位(quality_profile)
detail(细节优先)/ balanced(推荐默认)/ throughput(速度优先)。日常用 balanced;批量跑长视频用 throughput;出片验收用 detail。
3️⃣ 显存策略(memory_policy)
auto 按尺寸自动 / resident 模块常驻(快但吃显存)/ staged 在去噪和解码之间换载模块(省显存,稍慢)。显存紧张就 staged。
4️⃣ TE-Speed Video Combine(独家合帧节点)
比普通合帧快 50%,默认 NVIDIA h264_nvenc 硬编码;接音频只留一个最终文件;文件名支持时间变量(%date:yyyyMMdd_HHmmss%)自动按日期归档。
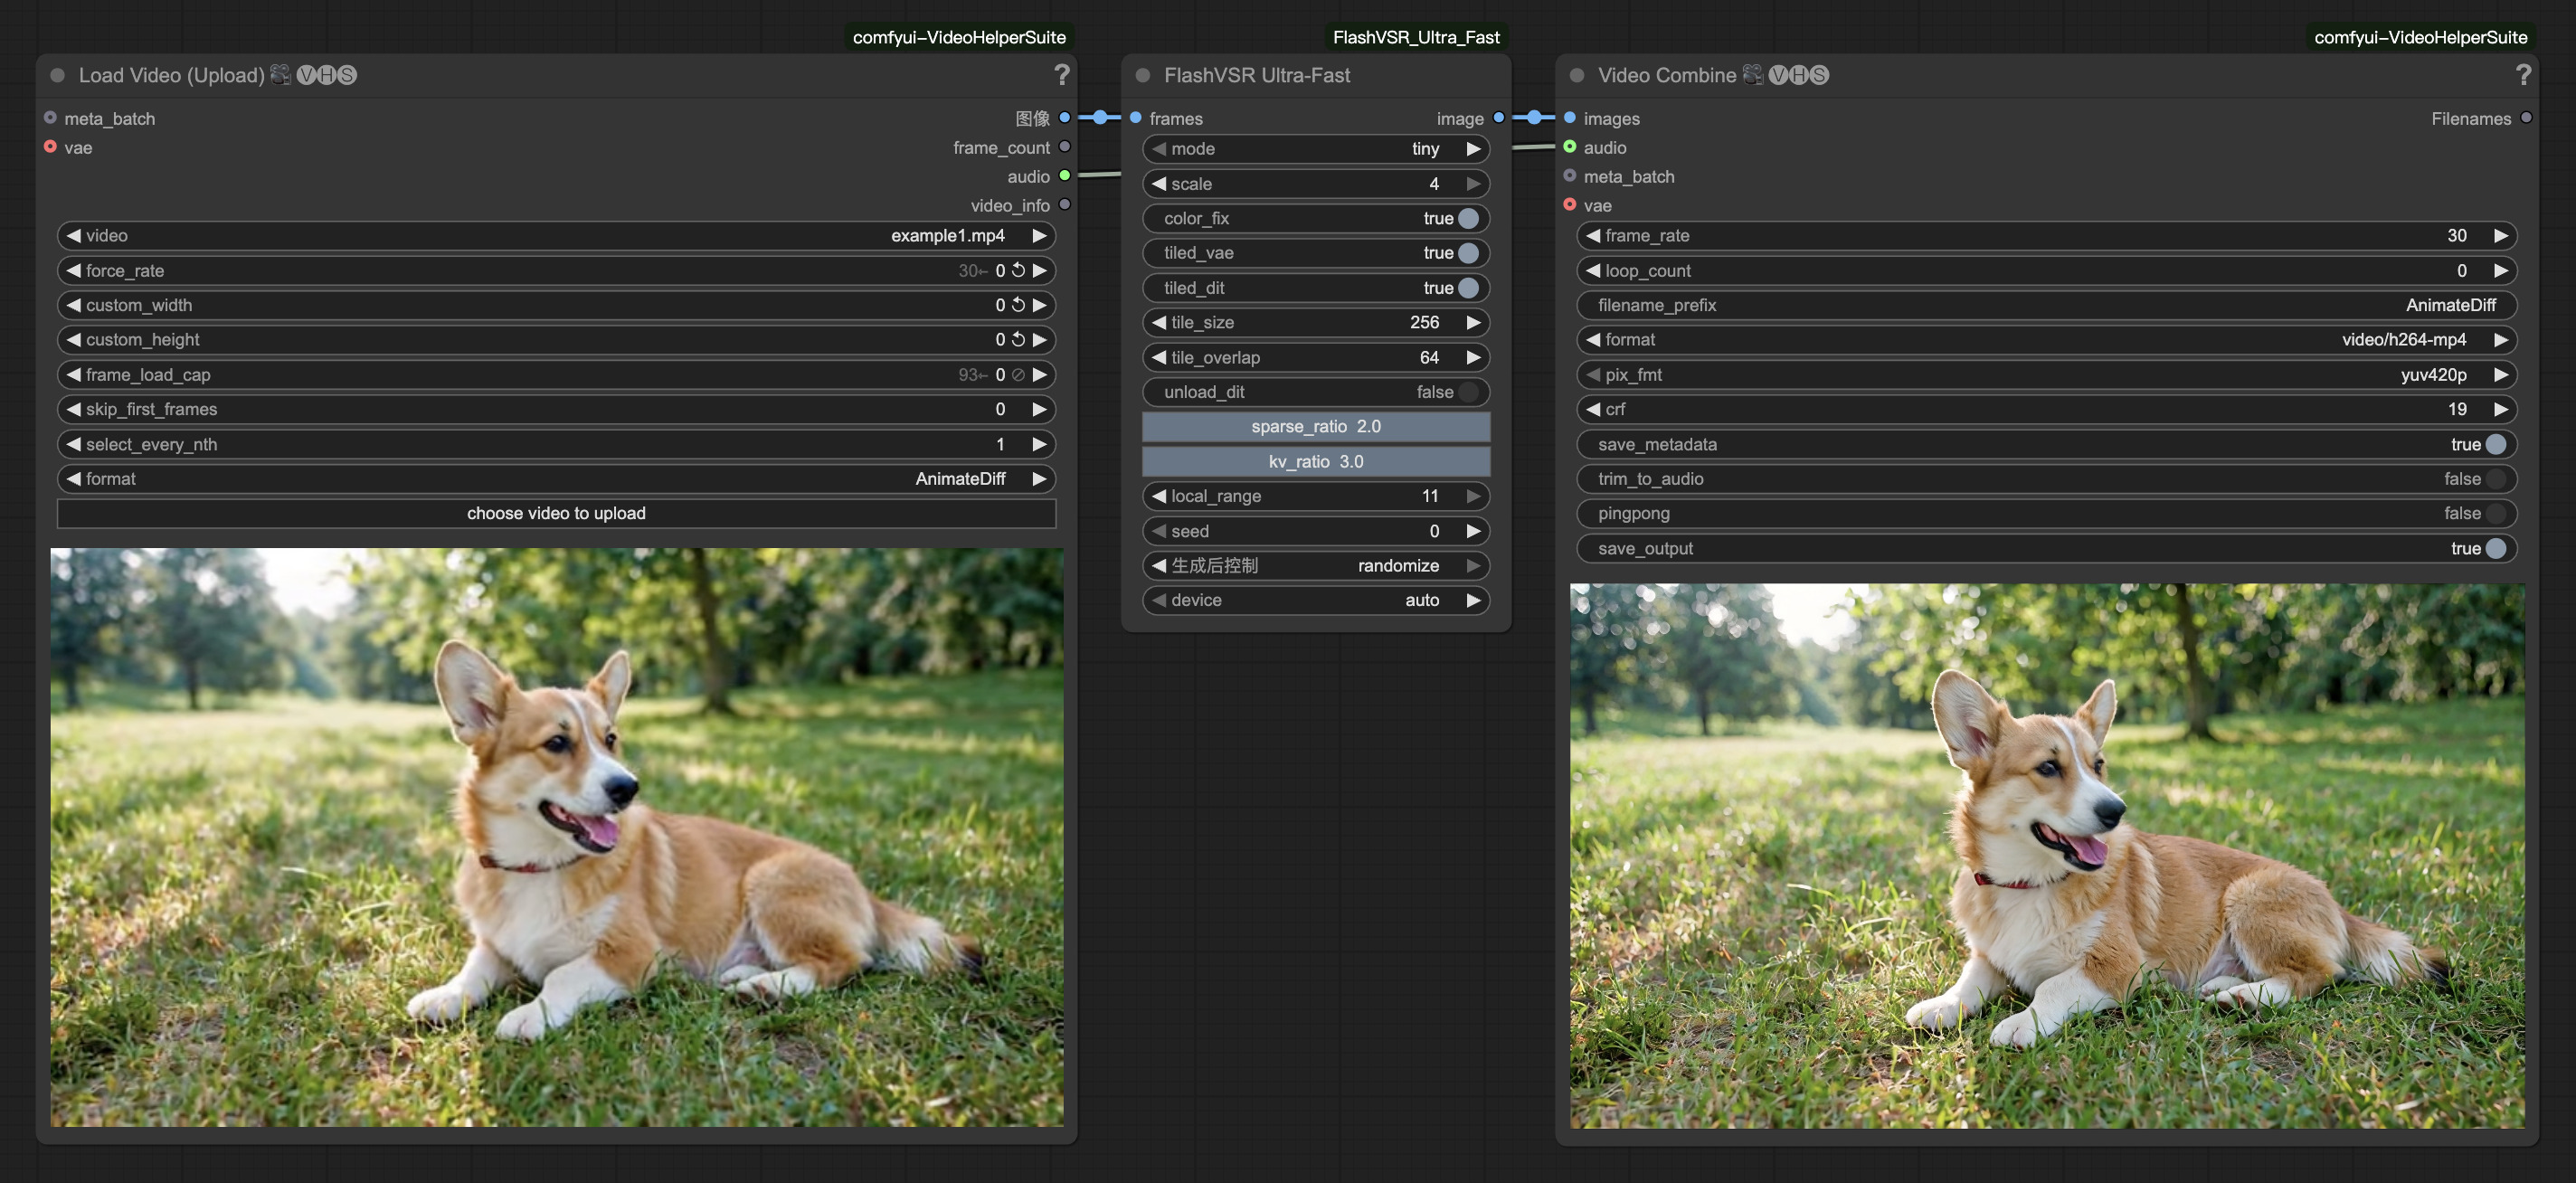
节点连接:加载模型(model=FlashVSR-v1.1, mode=tiny)→ 推理设置(Settings)→ 视频恢复(scale=4, color_fix 开)→ TE-Speed Video Combine(frame_rate 与源一致)。
环境要求:Windows x64 + Python 3.12+ + NVIDIA 显卡 + FFmpeg;需要 spas_sage_attn 轮子(作者夸克网盘提供,也有 TE 整合包)。
其余参数:attention_backend 默认 sparse_sage2 即可;max_tile_edge 默认 256;blend_overlap 24;spatial_strategy 用 auto。
💾 低显存配置表(8GB 也能跑)
| 配置档 | mode | VAE | 关键开关 |
|---|---|---|---|
| 8-12GB | tiny-long | LightVAE_W2.1 或 LightTAE_HY1.5 | Tiled VAE/DIT 全开 + chunk 16-32 + resize 0.5-0.8 + 模型驻留 CPU |
| 16GB | tiny | Wan2.1 或 LightVAE | Tiled VAE 开 |
| 32GB+ | tiny / full | Wan2.1(full 质量更高) | 可关 tiled 换速度 |
Ultra_Fast 对应开关:tiled_vae / tiled_dit / unload_dit(解码前卸载 DiT)——都是拿速度换显存,长视频优先开。
🕳️ 避坑指南(踩过的都在这)
1. 第三方实现缺 LCSA → 高分辨率画质崩
官方确认:部分早期 ComfyUI 版本没有 LCSA 模块、回退到稠密注意力,高分辨率下细节丢失和纹理混叠明显。选上文表格里的四条路线(都已处理),避开来源不明的整合包。
2. 别用 1× 缩放
模型按 4× 训练,官方明确建议 4× 设定,1× 效果没有保障。显存不够就 2×。
3. full 模式 ≠ 更快更好
full 用完整 Wan VAE 解码、不走 TCDecoder 加速,显存和耗时都更高;tiny 系列才是速度选择,画质差距很小。
4. 天空等平坦区域可能有块状痕迹
分块处理的通病,开 color_fix(小波颜色校正)可缓解;对画质要求高就减小分块(max_tile_edge 调低)。
5. 编译坑
官方代码依赖 Block-Sparse-Attention(编译过程吃内存),且只验证了 A100/A800(理想加速)/H200(加速有限);RTX 40/50 兼容性官方标注"未知"。消费卡别硬上官方代码——Ultra_Fast 就是为绕开这个编译而生。
6. 长视频
用 tiny-long 模式 / Ultra_Fast 长视频管线,显存占用明显更低,不容易中途 OOM。
📋 成本与时间预估(点开看)
本地:软件全免费。一张 8GB+ NVIDIA 卡即可起步(4060Ti 16G / 3060 12G 这类够用);一段 10 秒 480p→4× 视频,balanced 档在主流卡上大约 1-3 分钟(视显卡与分辨率浮动,以实测为准)。
云端:按次计费,适合偶尔用、无卡用户;下单前核对服务商跑的是 v1 还是 v1.1、是否完整管线。
- FlashVSR 官方仓库(OpenImagingLab,CVPR 2026)
- 论文:FlashVSR: Towards Real-time Diffusion-Based Streaming Video Super-Resolution
- FlashVSR 项目主页(LCSA / TC Decoder 原理)
- TE-Speed-FlashVSR(ComfyUI 节点,运动感知动态加速)
- ComfyUI-FlashVSR_Ultra_Fast(免编译实现)
- ComfyUI-FlashVSR_Stable(低显存配置指南)
- smthemex/ComfyUI_FlashVSR(最接近官方实现)
- 官方 LCSA 缺失警告(社区对比示例)
本文由加装AI助手整理发布 | 数据来源:FlashVSR 官方仓库 / 论文 / TE-Speed / Ultra_Fast / Stable 社区实测