Particle-1 把编码 Agent 的 token 账单砍掉三四成:模型没重训,只是学会了「少啰嗦」
在 DeepSeek V4.1 Flash 上加 1.25% 的 LoRA、纯靠 RL 改「干活习惯」:输出 token 少 28%~52%,单任务成本降 34%~52%,价格一分没降
Particle-1 把编码 Agent 的 token 账单砍掉三四成:模型没重训,只是学会了「少啰嗦」
3分钟看懂:这是什么、为什么重要、对谁有用
这是什么。 2026 年 10 月 28 日,旧金山初创公司 Particle 发布了第一款模型 Particle-1。它没有从头训练大模型,而是拿 DeepSeek 已经开源的 V4.1 Flash 1017 做底座,再训一轮,目标只有一个:让写代码的 AI Agent 用更少的 token 把同样的活干完。
为什么重要。 现在用 Agent 写代码,账单几乎全是 token。一个长任务动辄几万到十几万输出 token,其中绝大部分花在「想」——反复琢磨、反复自我检查、写一大段总结确认。Particle 的说法是:这部分浪费可以砍掉一大半,而模型能力几乎不动。它不是让模型更聪明,是让模型更省。
对谁有用。 已经在用编码 Agent(Claude Code、Codex、Kimi Code、自建 harness 等)并且按 token 付费的团队和个人;每天跑大量长任务、账单肉疼的人;想在自己的 harness 里换一个更便宜底座的人。
一句话总结:同样的智力,少说三四成的话。
它到底做了什么:不预训练,只改「干活习惯」
Particle-1 的做法,用一句话说就是「不改脑子,改嘴」。
底座是 DeepSeek V4.1 Flash 1017,这是 DeepSeek 在 10 月以 MIT 许可放出的开放权重模型。Particle 在这个底座上做后训练(post-training),加了一个 rank-64 的 LoRA 适配器,覆盖所有层的专家模块,可训练参数大约只相当于原模型的 1.25%。
训练分两段(它自己叫 Cascade RL):第一段只练编码,第二段把训练集主要转向数据工程。有意思的是,第一段练完之后,模型在没见过的数据工程任务上已经省了约 20% 的 token——这是团队第一次看到「省 token」这件事能泛化。
技术细节上还有几个点值得记一下:
- 策略更新用的是 GSPO(Group Sequence Policy Optimization),按整条序列算重要性权重和裁剪,而不是按 token。团队说按 token 算的 loss 会震荡甚至发散。
- 学习率固定在 5e-5,并且按 Dr. GRPO 的做法,不用组内标准差归一化优势。
- 训练栈建在 Miles(RadixArk 的开源 RL 框架)上,异步分布式训练,rollout 和 trainer 分节点;对 SGLang 和 Megatron 都做了改造来提吞吐、减小训练-推理不一致。
- 训练数据是自建的 Datamaker 合成数据系统造的,任务统一成 Harbor 格式,每个任务都自带验证方式,跑在 Terminus 2 agent 里。
换句话说,这是一次纯工程向的后训练:奖励函数只干一件事——任务成功,且用更少的 token。
四个「省 token」的具体动作
团队对比了同一个任务、同一个随机种子下「都做对了」的运行轨迹,总结出四种行为差异。这些不是抽象描述,下面每个都有真实数字。
1. 同样的动作,想得更少
选步骤和执行动作不变,但决策前的 deliberation 明显变短。即使工具调用次数不降甚至变多,token 也能省下来。
2. 干完就停
验证通过之后,不再反复推翻自己的决定、不再重复检查、不再写一大段最终确认。
一个典型例子:日历排期任务,两个模型都用 4 次模型调用、6 条命令,动作完全一致,差别全在「想」。约 94% 的节省发生在正确文件已经写好之后,收尾确认那一段从 5,193 token 降到 1,078。
3. 少几轮「试错-修补」
实现更直接,于是重复编译、打补丁、修错这几轮就少了。pMARS 构建任务里,底座反复回去改编译 flag、重装、重验,18 次模型调用;Particle-1 先读 Makefile 定好 flag 再编译,12 次调用搞定。
4. 探索和验证更聚焦
少花力气去试各种替代方案、少改边缘 case。团队也补了一句:额外的测试和文档有时候是有用的,所以看节省数字时要结合「这一轮到底交付了什么」。
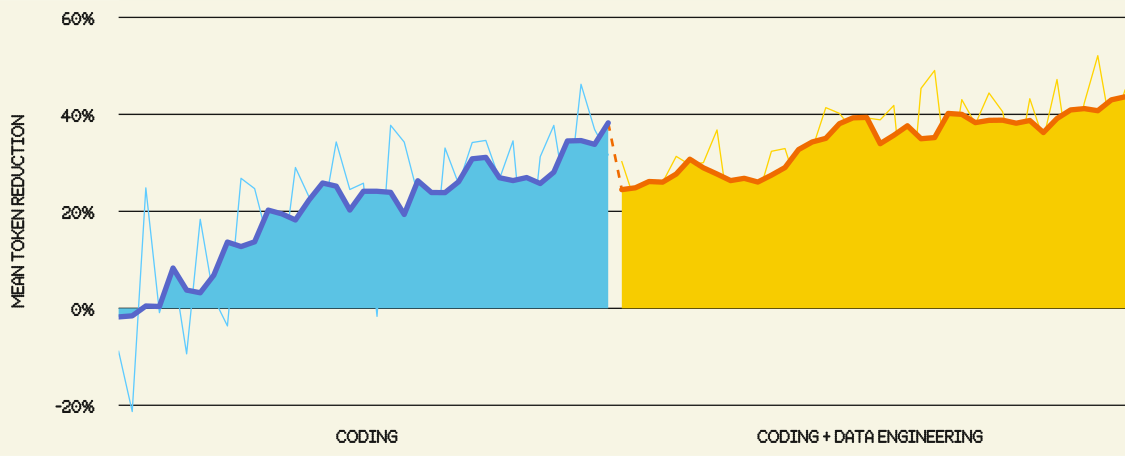 两阶段 Cascade RL:先练编码、再转向数据工程;图中标注了 token 节省随训练推进的变化(图源:Particle 官方发布博客)
几个可以直接对照的轨迹
| 任务 | 基准 | Particle-1 | 底座 | 省 |
|---|---|---|---|---|
| Git 部署 | Terminal-Bench 2.1 | 15,892 | 47,006 | 66.2% |
| pMARS 构建 | Terminal-Bench 2.1 | 6,766 | 17,070 | 60.4% |
| 日历排期 | Terminal-Bench 2.1 | 4,977 | 11,023 | 54.8% |
| cattrs 局部恢复 | DeepSWE 1.1 | 52,545 | 84,413 | 37.8% |
| Awilix 异步启动 | DeepSWE 1.1 | 52,933 | 81,327 | 34.9% |
| go-git 合并冲突 | DeepSWE 1.1 | 69,240 | 108,016 | 35.9% |
| CoreUI 导航 | ReactBench | 29,099 | 60,885 | 52.2% |
注意一个细节:go-git 那个任务,底座把手工测试套件跑了 20 遍。这不是能力问题,是习惯问题——而习惯正是这次训练要改的东西。
数据这一面:四个基准的整体账
Particle 在四个 agentic 编码基准上评测:Terminal-Bench 2.1(终端工作流:编译、调试、配系统)、ReactBench(建和修 React 应用,含功能/性能/可访问性)、ADE Bench(真实 dbt 项目与数据库上的分析与数据工程)、DeepSWE 1.1(需要读懂代码库、改实现、验证解法的长任务)。
官方汇总结论:
- 输出 token 少 28.4%~52.2%
- 单任务平均成本低 34.4%~51.6%
- pass@1 落在底座的置信区间内(也就是「没变差」)
- 四个基准平均约省 45% token
官方给的三模型对照(同一张表):
 官方插图「more work per token」:同样一个 token,能多干一点活(图源:Particle 官方发布博客)
| 指标 | Particle-1 | DeepSeek V4.1 Flash | GLM 5.3 Flash |
|---|---|---|---|
| 单任务成本(美元) | 0.2211 | 0.3368 | 0.6523 |
| 平均每任务输出 token | 59,580 | 83,246 | 98,155 |
| 任务通过率 | 72.57% | 71.15% | 66.82% |
按这张表,同样一批任务,Particle-1 的花费大约是底座的 1/1.5,是 GLM 5.3 Flash 的 1/3。
省下来的钱主要来自哪? 团队说,Terminal-Bench 2.1、ReactBench、ADE 这三个基准上,约 90% 的节省来自 reasoning token;DeepSWE 1.1 上工具调用的文本还额外贡献了约 30%。这条信息其实挺关键:它说明省的不是「少干活」,而是「少自言自语」。
通用能力有没有掉
后训练最怕的就是「专项变强、通用变傻」。Particle 给了四个通用基准:
- GPQA Diamond:90.40%(底座 90.91%)
- Tau Airlines:86.00%(底座 88.00%)
- MMLU:86.08%(底座 85.98%)
- BabyVision(带工具):89.18%(底座 89.60%)
基本在噪声范围内,Tau Airlines 掉了 2 个点,属于需要留意的单项。
还有一个挺有意思的边界实验:在 Harvey 法律基准的单个合同审查任务上,正常 adapter 强度下省 24.6% 输出 token,8 次尝试全部通过所有评分项;把 adapter 压得更狠,最多能省 78.7% token,但 8 次里只有 3 次通过严格检查。这就是这条技术路线的现实边界:省 token 和省质量之间有一条很硬的线,Particle 选择站在线的这一侧。
怎么用:三个入口、一个价格、几个参数
入口。
- 自有 API:
particle-1(公开模型 ID 是particle-ai/particle-1,OpenAI 兼容) - OpenRouter:
particle-ai/particle-1 - Vercel AI Gateway:10 月 28 日同步上架
价格(官方文档,每百万 token)。
- 输入:$0.25
- 缓存输入:$0.03
- 输出:$1.00
- 网页搜索:按千次计费
- 低峰时段(纽约时间 20:30–04:00)半价(Flex 档位同样五折)
注意:这个价格和它底下那个 DeepSeek V4.1 Flash 的标价一模一样。 这一点很关键——Particle 没有降价促销,它卖的是「同样的单价,更少的 token」。
规格。
- 上下文:1,048,576 token(prompt + completion 合计)
- 默认输出上限:32,000;显式指定最高 131,072
- 模态:文本 + 图片输入,文本输出;单图 ≤16 MiB,总计 ≤100 MiB,不限张数
- 推理强度:
reasoning_effort默认high,可调 - 工具调用:支持 OpenAI 的
tools/tool_choice - 结构化输出:只接受
json_object,json_schema会原样透传但没有 schema 保证 - 数据:官方称推理流量零保留,prompt 和 completion 只在内存中处理
适用场景 / 不适用场景
适合:
- 已经在跑长任务编码 Agent,token 账单占大头
- 用 OpenAI 兼容接口、换模型只需改一个 model 名
- 任务以软件工程为主(这是这一版唯一的训练域)
- 愿意自己跑 A/B 验证,而不是直接相信宣传数字
不适合:
- 需要最强绝对能力的前沿任务——它和底座同级,不是升级
- 非软件工程领域(法律、金融、多模态创作等):这一版明确只练了软件工程
- 需要严格 schema 保证的结构化输出流水线
- 需要第三方独立评测背书才能采购的合规场景
避坑:五个必须知道的限制
- 全部数字都是自测。 没有第三方复现。首次上公开榜单的结果才是真正的检验。
- 美元成本数字对不上真实账单。 有媒体指出,官方博客的成本脚注用了比现行 API 更高的价格假设,所以「每任务多少美元」不能直接当账单看;百分比节省仍然成立,因为两个模型同价。
- 基线争议。 有研究者在 X 上质疑对比是否用了旧版 DeepSeek checkpoint,创始人回应说对比的就是 1017。这一点目前只能采信官方说法。
- 法务/非编码结论样本极小。 只有一个合同审查任务、8 次尝试,不能推广到「法律工作也能省 25%」。
- 安全评估缺失。 Particle 没有发布自家安全评测;底座模型此前被研究机构指出过监督缺口。
另外提醒一句:所有节省数字都是在 Terminus 2 这个特定 agent harness、512K token 限制、最大推理强度、每任务 16 次尝试的设置下测的。换个 harness,数字会变。 这也是为什么官方自己说「这个结论很容易被验证」——你把自己的日志拉出来比就行。
成本与时间预估
自己做一次验证大概要多久? 半天到一天:
- 从现有流水线里挑 10~20 个代表性的长任务(要覆盖你真实的工作类型,不要挑最简单的)
- 固定 harness、固定 prompt、固定随机种子
- 同一批任务分别跑底座和 Particle-1,记录:输出 token、总成本、通过率
- 重点看「通过率没掉、token 明显降」的比例,而不是平均值
成本大概什么量级? 按官方价格,一个消耗 6 万输出 token 的任务约 $0.06 输出费,加上输入费用通常不到 $0.1。20 个任务、两个模型各跑一遍,通常是个位数美元级别的实验。相对于「长期账单省三四成」,这个验证成本基本可以忽略。
给新手的第一步
如果你只是想先感受一下:在 OpenRouter 上把模型名从 deepseek/deepseek-v41-flash-1017 换成 particle-ai/particle-1,跑你平时最常跑的那条命令,对比两次的 token 用量。不用改任何其他代码——这就是它最大的产品设计:不要求你迁移,只要求你换个名字。
至于要不要长期用:先看你自己日志里的数字,再看公开榜单有没有第三方复现。Particle 卖的是一个可以被你自己验证的承诺,这比任何 benchmark 图都实在。
参考来源
- Particle 官方发布博客《Introducing Particle-1》(2026-10-28):https://particle.ai/blog/introducing-particle-1
- Particle 官方 API 文档 · 模型目录(价格、上下文、参数):https://docs.particle.ai/models
- Particle 官方定价页:https://particle.ai/pricing
- Vercel AI Gateway changelog《Particle-1 is now available on AI Gateway》(2026-10-28):https://vercel.com/changelog/particle-1-is-now-available-on-ai-gateway
- OpenRouter 模型页:https://openrouter.ai/particle-ai/particle-1
- TSN Media《Particle-1 Coding Model Uses About 45% Fewer Tokens, Particle Says》(2026-10-29,含价格与质疑部分):https://tsnmedia.org/particle-1-token-efficient-coding-model/
> 说明:模型规格、价格、benchmark 数字与训练细节来自 Particle 官方博客与官方文档;价格核对、基线质疑、法务任务样本量与安全评估缺失等批评性信息,基于多家媒体转述整理(TSN Media、opentools、Vercel changelog 等对同一发布事件的交叉印证),核心事实一致。
所有效果数字为厂商自测;换 harness、换任务集后的实际节省幅度请以你自己的日志为准。